
技術
会話の中身を、
正しく聞き、理解し、測る技術
2013年から積み重ねてきた会話研究が
国内外の多数の特許取得に。
その全体像をご紹介します。
私たちの技術は、会話を扱う3つの段階に並んでいます。まず正しく聞く。次に会話を理解する。そのうえで論点ごとに測る。どれか一つが欠けても、次の段階が成り立ちません。専門用語を聞き誤れば論点を正しく切り出せず、論点が正しくなければ、練習も評価も別のものに対して行われてしまうためです。
論点——何について話すか(トピック)のなかで、判断や説明が必要になる問い——を切り出します。取り上げる論点と取り上げない論点は、ねらいに応じて選べます。問いごとに納得を重ねることが、会話での理解の積み重ねになります。このページの技術は、いずれもこの単位を正確に扱うためのものです。

誤変換補正の特許1 正しく聞く
専門用語対応(音声認識・誤変換補正)
御社の言葉が正しく認識されなければ、会話は資産になりません。
- なぜ誤変換が問題になるのか:金融の商品名、薬剤の一般名、社内だけの略語は、一般的な語彙の外にあるため、音声認識の候補に上がりにくい語です。誤変換された文字は、そのまま発言として生成AIに渡り、返答も評価もその文字に対して行われます。
- どこで直すのか:当社は業界に特化した専門用語辞書と、誤変換を補正する層を自社で保有しています。これらの語を先に登録したうえで、生成AIに渡す前に認識結果を補正します。
- 実測値:専門用語を含む営業の会話で、音声認識99.4%。個別の調整を行わない状態での、2026年の実測値です。ディープラーニングによる調整を行った場合は、2024年に99.9%を達成しています。
残る誤りも、読点の欠落と、1文字の誤字が中心です。文の意味を決める専門用語そのものは、正しく通っています。

特許取得2 会話を理解する
会話解析
会話を「読める資産」に変換する土台の技術です。言い淀みや語順の乱れといった話し言葉特有のゆらぎを含む会話を、適切な話者分離と共にセンテンス単位で判定します。2013年から積み重ねてきた独自の自然言語処理です。
この会話解析の土台の上に生成AIを載せているため、ビジネスの現場で求められる精度とコンプライアンス遵守を両立できます。

特許取得2 会話を理解する
論点抽出
資産から論点と質疑応答を取り出す技術です。長時間のセミナー動画や論文からでも、AIが論点を解析し、専門用語を落とさず要点を凝縮した要約文(高密度要約文)を作成します。高密度要約文は、生成AIに学ばせるために最も適したデータです。
質疑応答も同時に自動生成できるため、既存の資産をそのままトレーニング教材へ変換できます。

特許取得3 論点ごとに測る
論点ごとの評価
キーワードへの反応ではなく、論点の単位で会話を追い、どの論点を話せて、どの論点が抜け落ちたかを判定します。単語が出たかどうかではなく助詞を含んだ文の形で見るため、論点の網羅・説明の正確性・ヒアリング・質問の質・コンプライアンスという5つの観点で測れます。
この評価を担うのは、相手役の生成AIではなく、当社が保有する評価レイヤー(5つの評価層・特許取得)です。相手役と評価役に、役割の異なるAIを使い分ける設計です。5層それぞれの働きと登録番号は、評価を行う5つの層と、その登録特許に掲載しています。
ナレッジマネジメントには、
2つの技術が欠かせません
商談・応対・練習の会話データを、組織で使える知識(ナレッジ)として蓄積し活用する——企業のナレッジマネジメントには、音声認識と論点抽出の2つを組み合わせて活用することが最も効率的だと、私たちは考えています。
-
音声認識(誤変換補正・専門用語対応)
1件だけなら、誤変換は読む人が頭の中で読み替えられます。数百人分を蓄積して集計する場面では、同じ誤変換が「存在しない論点」として数字に化けます。
専門用語が正しく認識されて初めて、集めた数字をそのまま意思決定に使えます。だから補正は、蓄積するより前の段階に置いています。 -
論点抽出
会話は話し言葉です。言い淀み、語順の乱れ、指示語や省略が当たり前に混ざります。録音を文字にしただけのデータは、そのままでは検索も集計もできません。
「何が論点だったのか」を機械が判定できて初めて、数百人分を横並びで比較し、組織の知識として引き出せるようになります。
この2つがそろって、はじめて会話データが組織のナレッジになります。当社は音声認識(専門用語補正)と論点抽出の両方を自社のレイヤーとして保有しているため、御社の言葉づかいと、御社が選ぶ論点に合わせて調整できます。
評価を行う5つの層と、
その登録特許
対話中の評価は、1つの技術ではなく、役割の異なる5つの層でできています。この5層の上に、製薬(MR・MSL)・金融・製造業・小売といった業界ごとの評価指標が載り、御社ごと・コースごとに調整できます。
5層の例を、登録特許とあわせてご紹介します。
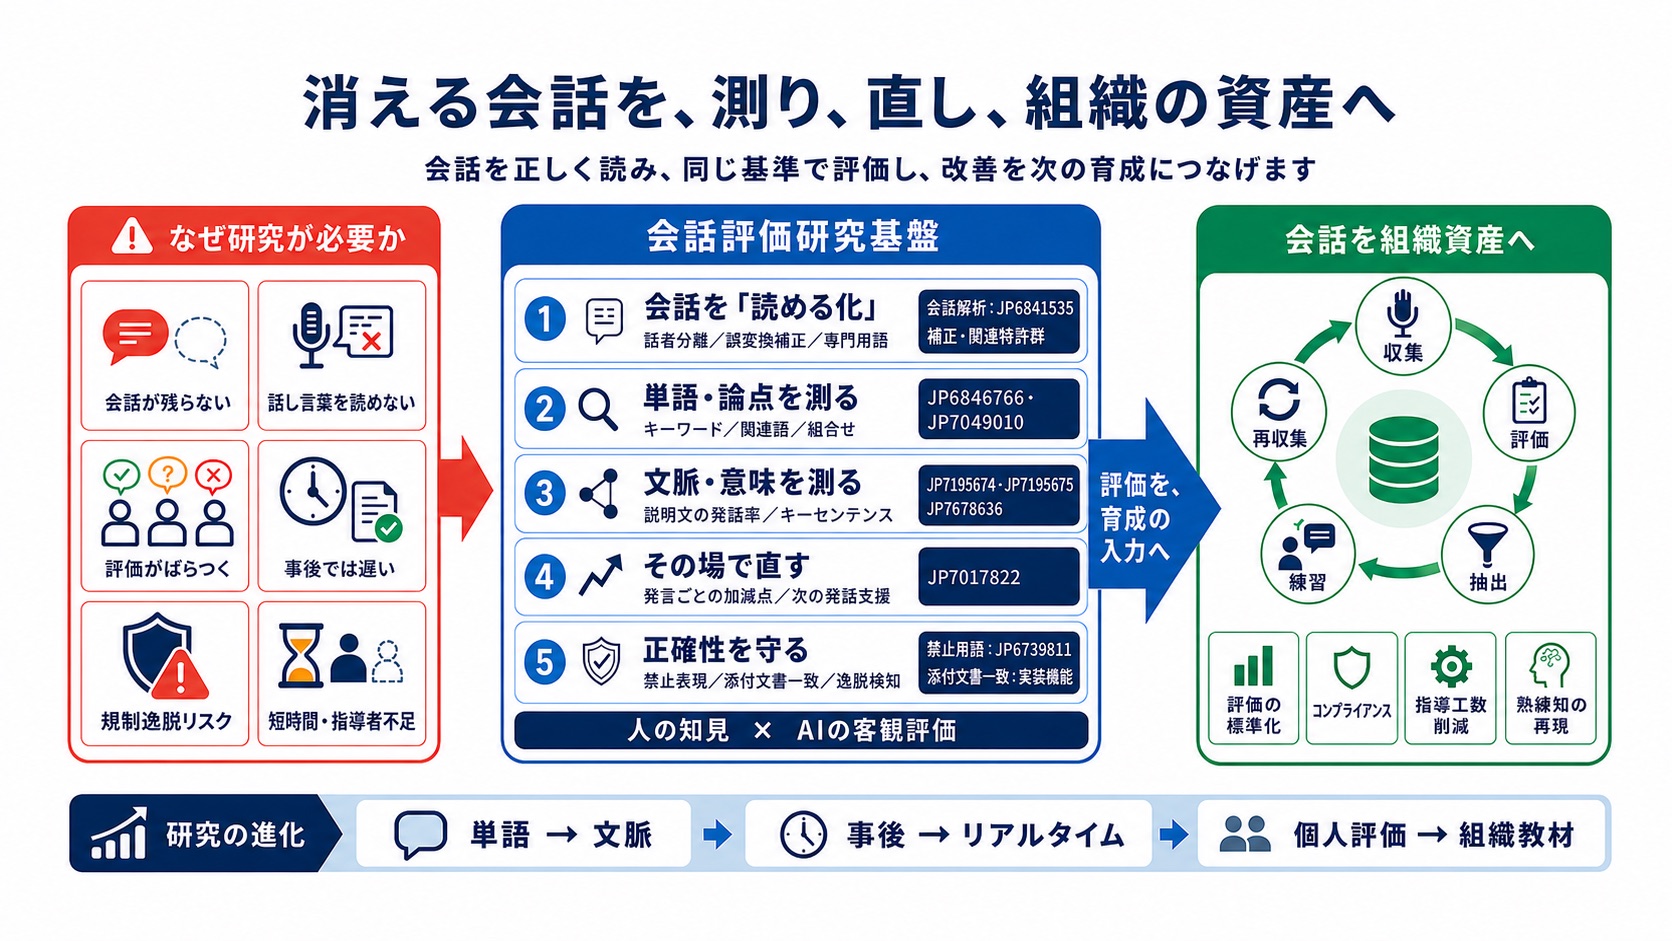
こちらの図は横スクロールできます / 図を拡大表示。図中の5つの工程が、下の表の5つの層に対応します。
| 層 | 何をしているか | 主な登録番号 |
|---|---|---|
| 発言ごと | 発言を種類に振り分け、直前との並びで評価する | 特許7017822 等 |
| 文脈 | 単語の一致ではなく、助詞を含む文の形で見る | 特許7678636 等 |
| 次の一手 | 評価の高い次の展開と、対応する資料ページへ誘導する | 特許7612269 等 |
| 止める | 問題になる表現を、評価の前に指摘する | 特許6739811 等 |
| 土台 | 文の切り出しと、話題に応じた音声認識の補正 | 特許6841535 等 |
相手役と評価役に役割の異なるAIを使い分けるのは、評価の基準を御社側に置くためです。相手役の基盤モデルは進化に合わせて入れ替え、評価はこの5層(特許取得)が担い続けます。基盤モデルが変わっても、同じ基準で測り続けられます。この設計は、2023年のChatGPTとiRolePlayの連携(デュアルAI)から続いています。
自社技術と基盤モデルの関係
基盤モデル(大規模言語モデル)は用途とセキュリティ要件に応じて最適なものを選択し、進化に合わせて入れ替えます。当社が自社で保有しているのは、会話解析、専門用語補正、論点抽出、教材生成、評価、企業専用データ管理という、業務成果を決定するレイヤーです。実際の対話では、ChatGPT・Claude・Geminiといった複数の生成AIを用途に応じてリアルタイムに使い分けるAIオーケストレーション技術を用いています(2026年5月発表別ウィンドウで開く)。
この構成により、基盤モデルの進化を素早く取り込みながら、精度・統制・データ管理は顧客企業各社が独立したレイヤーで担保可能としています。
関連ニュース
ここまでの技術がどう形になってきたかは、会社概要の「技術の歩み」で年表としてご覧いただけます。
- 「iRolePlay」および「Interactive-Pro」がAWS ファンデーショナルテクニカルレビュー(FTR)を通過
- 複雑な医薬品「添付文書」を学習データとする、生成AI技術を開発
- セミナー動画から論点抽出、質疑応答をAIで自動生成し「iRolePlay」と自動連携
この技術を、安心してお使いいただくために。
データの取り扱い・第三者評価・導入審査のご支援をまとめています。
お問い合わせ
こちらからお気軽にお問い合わせください。