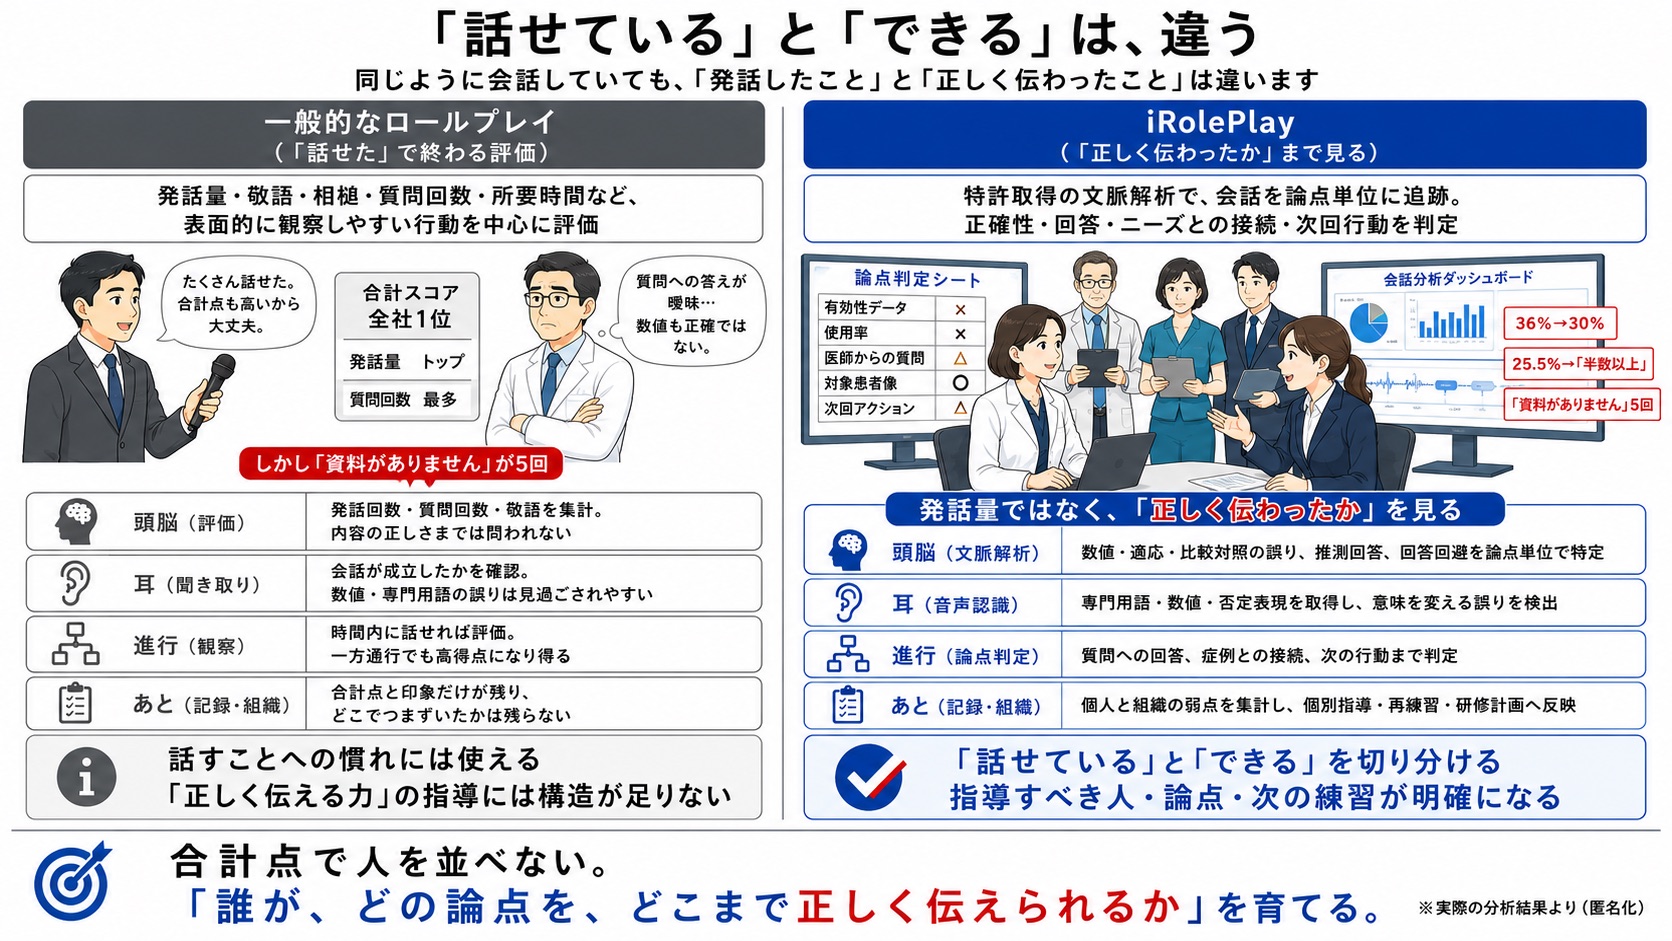
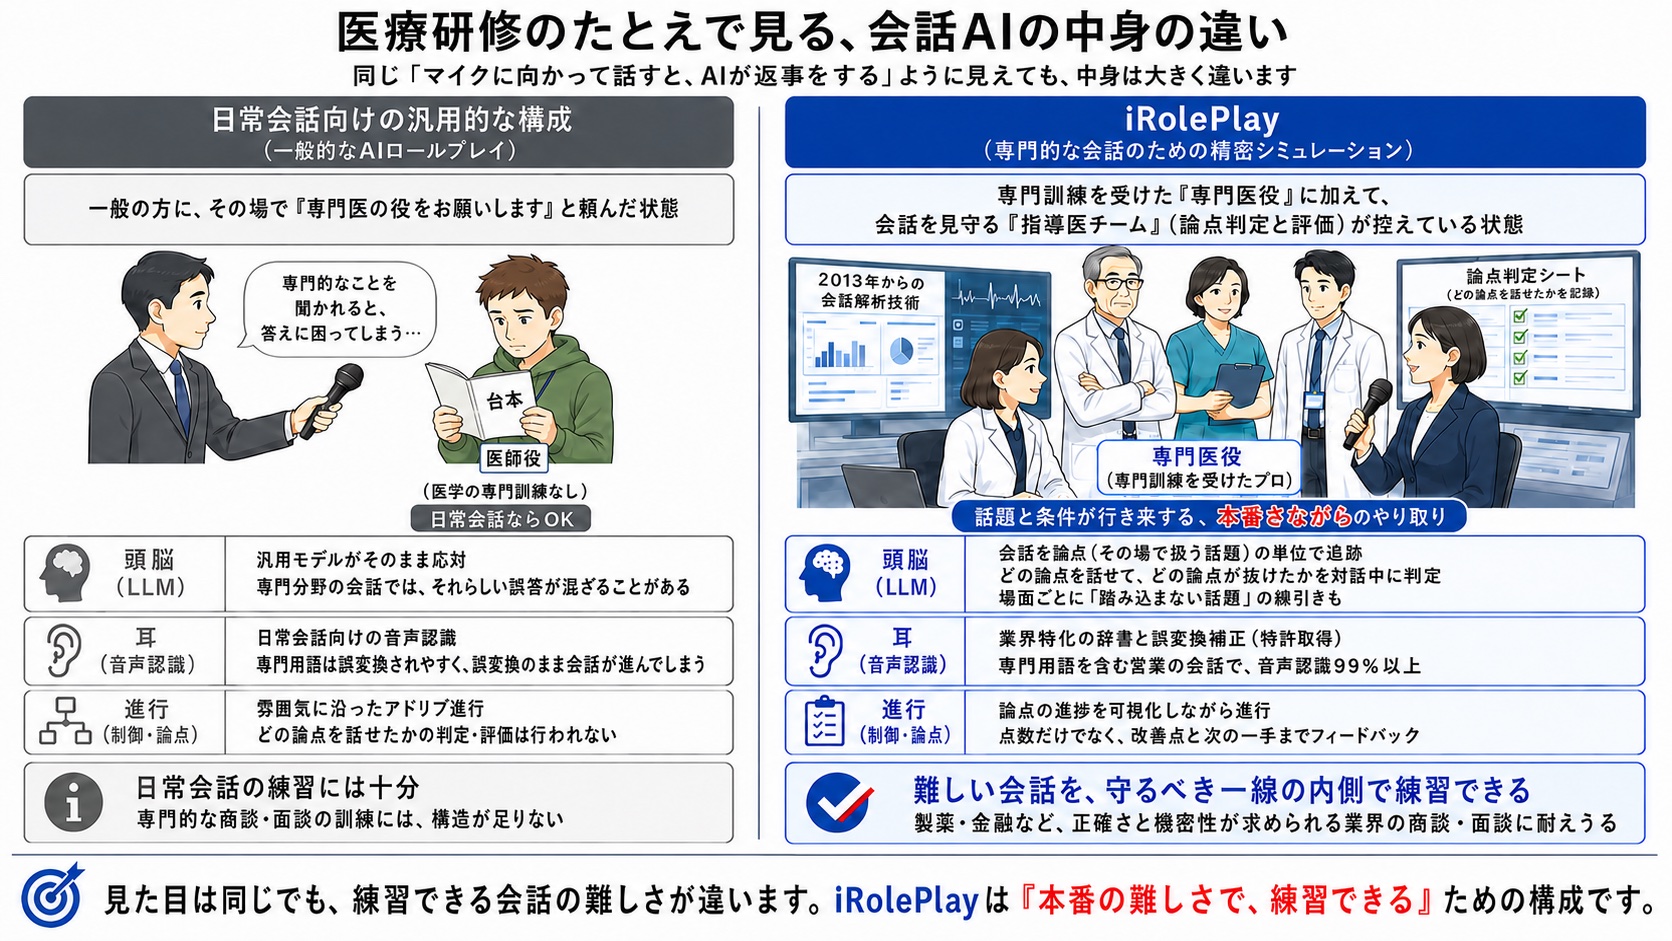
音声認識・論点の評価・資料にない説明への備えを、仕組みから比べる
「社内で使えるChatGPTに『気難しいお客様の役をやって』と頼めば、それで営業のロープレになるのではないか」
生成AIの活用を進める企業であれば、一度は検討されるアイデアです。若手の営業担当者がひとりで壁打ちをしたり、商談の切り出し方を考えたりする程度であれば、汎用のChatGPTでも十分に役立ちます。
しかし、それを全社の研修の基盤として導入し、スキルの底上げや評価に直結させようとすると、多くの場合、3つの技術的な壁に突き当たります。
なお、当社のAIロープレ(AIロールプレイ研修)「iRolePlay」も、会話の相手役には、OpenAIのモデルを含む外部の基盤モデル(大規模言語モデル)を使っています。違いは基盤モデルそのものではなく、その前後に重ねている仕組みにあります。本稿では、汎用のチャットAIをそのまま使う場合とiRolePlayの構造の違いを比べながら、実務で使えるAIロープレの選び方を整理します。
ChatGPTをそのまま使うと、研修の基盤でつまずく3つの理由
汎用のChatGPTでロープレを自作したときの、3つのつまずき
- 難易度の揺らぎ:プロンプトで制御しきれず、すぐに納得する「都合のよいお客様」になる
- 音声認識の壁:専門用語や製品名の誤変換で、会話の文脈が崩れる
- 評価のあいまいさ:講評が好意的な言葉に偏り、次に何を直せばよいかがわからない
① プロンプトで制御しきれない、難易度の揺らぎ
どれほど厳密に「反論してください」と指示しても、汎用のチャットAIは、利用する人の問いかけに親切に応じるように作られています。生成AIには相手に寄り添うようにふるまう性質があるため、営業担当者がそれらしいことを言っただけで、あっさり納得してしまう「都合のよいお客様」になりがちです。
逆に、反論を強めようとしてプロンプトを複雑にすると、理不尽な難癖を繰り返すだけの、かみ合わない会話になります。必要なのは、論点——何について話すか(トピック)のなかで、判断や説明が必要になる問い——の単位で会話を追い、「どの論点まで話せたら、相手が納得してよいか」という到達の条件を持たせることです。これを、ひとつのプロンプトの書き方だけで制御するのは、きわめて難しいのが実情です。
② 専門用語を正確に拾えない、音声認識の壁
キーボードで打つチャットの練習と、実際の営業の現場を模した「声に出す練習」とでは、大きな差があります。音声入力を通した途端に、医薬品の一般名や金融商品の固有名詞、社内用語の誤変換が増えるからです。
音声認識が「対象になる」と「対象にならない」を取り違えて文字にしてしまえば、その先のAIは事実と正反対の文脈でお客様の役を演じることになり、その後の評価も狂ってしまいます。誤変換された文字は、話した方の発言としてそのまま生成AIに渡るため、話した本人は原因に気づけません。
③ 講評が好意的な言葉に偏り、直すところが見えない
ChatGPTにロープレの後の講評を頼むと、「とても丁寧で誠実なご対応でした。お客様のニーズをしっかり引き出せています」といった、好意的な講評が返ってくる傾向があります。
しかし、営業の指導で本当に知りたいのは、伝えるべき5つの論点のうち、どれが抜け落ちたのか。言ってはならない表現を、どこで使ってしまったのかです。評価の基準と発話の記録が結びついていなければ、受講される方は、次に何を直せばよいのかがわかりません。
専用AIロープレ「iRolePlay」の、3つの技術的なアプローチ
こうした課題に対して、iRolePlayでは、会話の相手役を務める生成AIの前後に、会話を正しく扱うための層を重ねています。
① 業界に特化した専門用語辞書と、誤変換補正
iRolePlayは、汎用のモデルに音声を直接渡すのではなく、その手前に業界に特化した専門用語辞書と、誤変換補正技術(特許取得)を置いています。専門用語の誤変換を、生成AIに渡す前に直します。
結果は、専門用語を含む営業の会話で、音声認識99.4%です(個別の調整を行わない状態での、2026年の実測値)。ディープラーニングによる調整を行った場合は、2024年に99.9%を達成しています。製品名や制度の用語が正しく文字になるため、会話の文脈が崩れません。測定の条件は技術ページでご説明しています。
② 会話を論点に分けて評価する
会話全体にひとつの点を付けるのではなく、商談を必須の論点に分け、論点ごとに判定します。
- 何を話したか(網羅性):伝えるべき論点(費用、リスク、活用の事例など)に触れたか。その場面で言うべき重要なフレーズを、実際に言えた割合で測ります
- どう話したか(質):単語を口にしただけでなく、前後の文脈に沿った正しい説明になっているか。キーワードの一致ではなく、助詞を含んだ文の形で判定します
- コンプライアンス:断定的な表現や、ガイドラインに反する発言がなかったか。問題になる表現は、評価より先に指摘します
受講される方には「合計75点」という数字だけでなく、「『解約時のリスク』のご説明が抜け落ちていたため、もう一度練習しましょう」といった、次に取り組むことまでが返ります。会話の相手役は生成AIが務め、点を付けるのは当社の評価レイヤー(特許取得)です。役割の異なるAIを使い分けているため、会話の自然さと、点の付け方の一貫性を、別々に整えられます。
③ 資料にない説明を、見過ごさないための線引き
生成AIは、事実と異なる内容をもっともらしく語ってしまうことがあります。正確さが求められる企業の研修では、見過ごせない問題です。iRolePlayのAIは、承認済みの資材のみを参照し、範囲外は記録します。最終確認は人が行います。
製薬企業様向けには、練習中の発話を添付文書と照合し、一致度をその場で評価する機能があります。公式文書から外れた説明や、その回で取り上げないと設定した話題(適応外・未承認の効能効果など)への踏み込みは、うまく話せたかを評価する前に指摘します。生成AIの自由な対話を生かしながら、会社の公式見解から外れた説明を見過ごさないための線引きを設けています。
※ 販売情報提供活動ガイドラインをはじめ、法令・ガイドラインへの適合そのものを判定・保証するものではありません。
汎用AIの直接利用・APIでの内製・専用ツールの比較
「APIを使って自社で内製するか、専用のサービスを導入するか」を判断するための比較表です。他社の製品やサービスの性能を評価したものではなく、構成の違いから生じる一般的な特性を整理しています。
内製と専用ツール、どちらを選ぶか
内製が適しているのか、専用ツールの導入を急ぐべきなのかは、目的によって分かれます。
汎用AIの直接利用・内製が向いているケース
- 気軽な雑談や、アイデア出しの相手としての壁打ち
- 社内に専任のAIエンジニアのチームがあり、画面から評価の仕組みまで、継続して保守・改修できる体制がある
- 扱う商材に専門用語が少なく、法規制や説明責任にかかわるリスクが低い
専用ツール(iRolePlay)を優先したいケース
- 金融・製薬をはじめ、ひとことの説明の誤りが、コンプライアンス上の問題につながりうる業種
- 全国の支店・営業所で、そろった客観的な基準でスキルを確かめたい
- 人事や営業企画の方が、コースづくりやプロンプトの調整に時間を取られず、現場の育成に専念したい
まとめ——対話AIの価値は、流暢さではなく論点の定着にある
相手役のAIが流暢に相づちを打つこと自体には、研修としての価値はあまりありません。
現場の担当者が、伝えるべき論点を逃さず、相手に合わせて正しく声に出せるようになること。そして管理者が、組織全体の会話の質を、客観的なデータとして把握できること。この2つがそろって初めて、AIロープレは「お試し」を超えて、育成を支える基盤になります。
まずは社内の研修資料1本から、御社専用のロープレがどう立ち上がるのか、その違いをお確かめください。資料をアップロードいただければ、最短20分で実際に動くコースをご覧に入れます(資料の分量により、目安20〜30分)。